
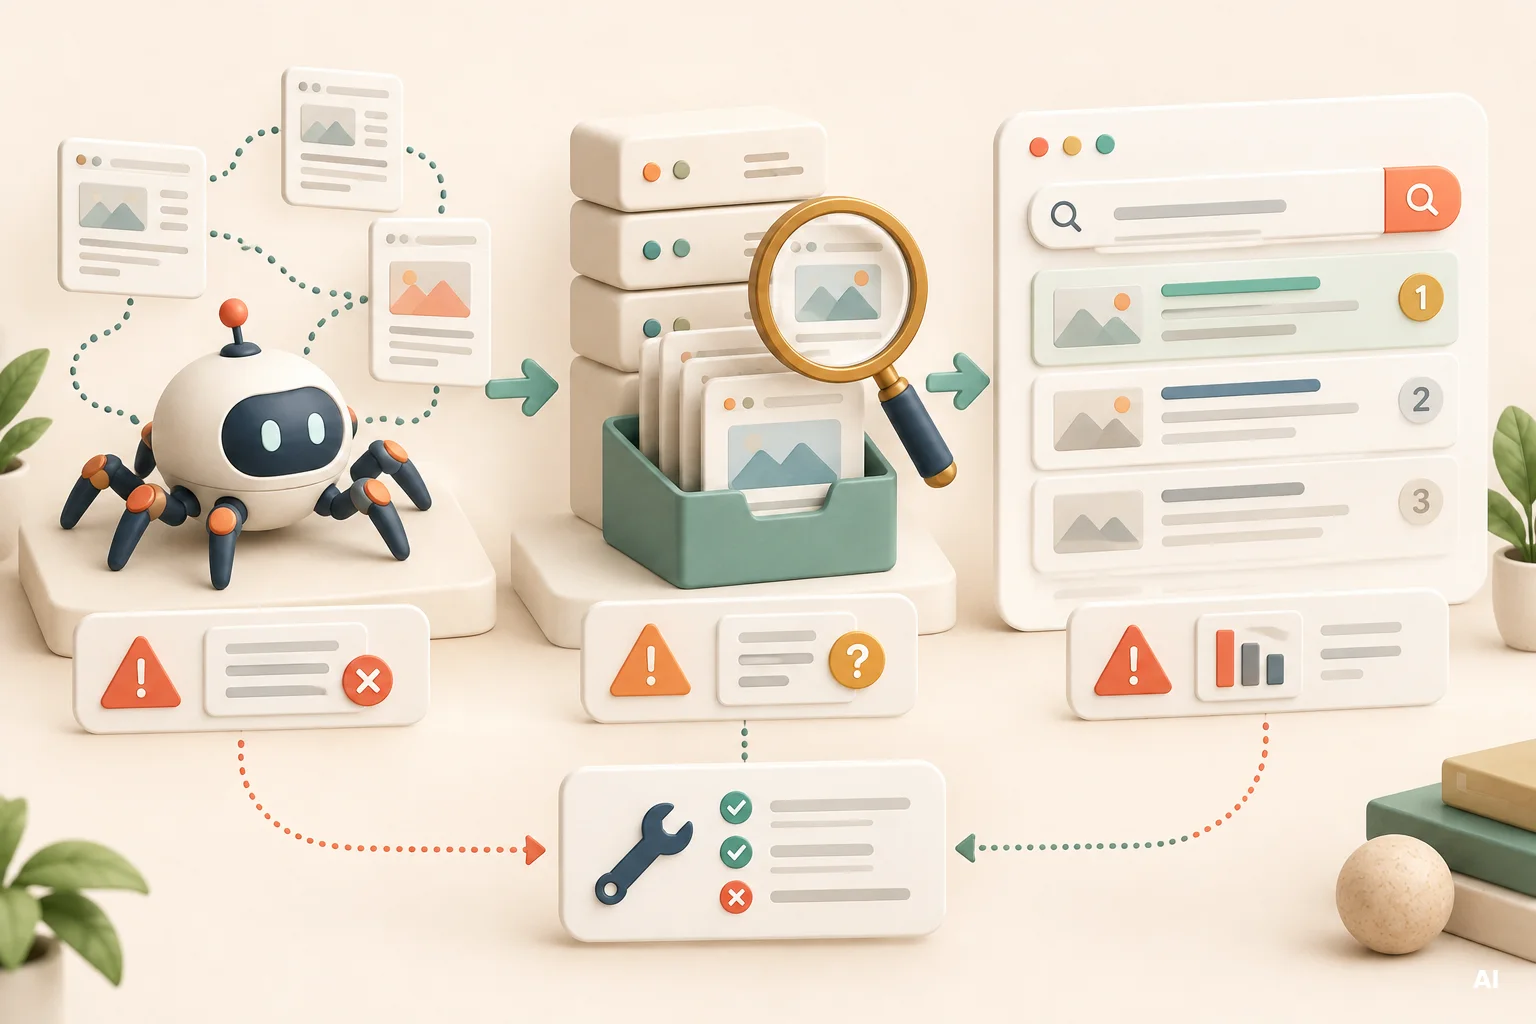
Wyszukiwarki pomagają ludziom znajdować przydatne informacje wśród miliardów stron internetowych, ale ich działanie obejmuje więcej niż proste dopasowywanie zapytania do powtarzających się słów kluczowych. Aby zrozumieć, jak działają wyszukiwarki, warto podzielić ten proces na trzy główne etapy: skanowanie, indeksowanie i ustalanie pozycji. Strona może pomyślnie przejść jeden etap i napotkać problemy na kolejnym, dlatego widoczność wymaga zarówno rozwiązań technicznych zapewniających dostęp do strony, jak i trafnych, użytecznych treści. Jeśli dopiero poznajesz ten temat, zacznij od tego poradnika optymalizacji stron pod kątem wyszukiwarek dla początkujących.
Co robi wyszukiwarka?
Wyszukiwarka porządkuje informacje, aby odpowiadać na zapytania użytkowników trafnymi wynikami. Automatyczne programy odkrywają dostępne adresy URL, pobierają ich zawartość, analizują treść każdej strony i zapisują informacje spełniające odpowiednie warunki w indeksie, który można przeszukiwać. Gdy ktoś przeprowadza wyszukiwanie, systemy ustalające pozycje oceniają potencjalne dopasowania i decydują, które wyniki zaprezentować.
Choć proces ten często opisuje się jako skanowanie, indeksowanie i ustalanie pozycji, są to odrębne działania. Skanowanie oznacza odkrywanie zasobu i uzyskiwanie do niego dostępu. Indeksowanie obejmuje analizowanie i zapisywanie informacji o nim. Ustalanie pozycji następuje wtedy, gdy wyszukiwarka wybiera i porządkuje zindeksowane zasoby dla konkretnego zapytania. Odkrycie strony nie gwarantuje jej zindeksowania, a zindeksowanie nie gwarantuje dobrej widoczności w wynikach wyszukiwania.
Etap 1: jak wyszukiwarki skanują internet
Skanowanie przez wyszukiwarki to proces znajdowania adresów URL i wysyłania żądań pobrania ich zawartości za pomocą automatycznego oprogramowania, nazywanego zwykle robotami indeksującymi, pająkami lub botami. Wyszukiwarki nie dysponują jednym katalogiem zawierającym wszystkie strony w internecie, dlatego muszą stale odkrywać nowe i zaktualizowane adresy URL.
Jak roboty odkrywają adresy URL
Robot może znaleźć stronę, podążając za linkiem ze strony, którą już zna, przetwarzając przesłaną mapę witryny lub ponownie odwiedzając adres URL odkryty podczas wcześniejszego skanowania. Linki są szczególnie ważne, ponieważ tworzą ścieżki między zasobami. Google podaje, że wiele nowych stron jest odkrywanych dzięki linkom, a nie ręcznemu zgłaszaniu.
Nowa strona, której nie uwzględniono w nawigacji, do której nie prowadzi link z innej dostępnej strony ani której nie wymieniono w mapie witryny, może być trudna do odkrycia. Taki odizolowany adres URL bywa określany jako strona osierocona. Logiczna struktura ogranicza to ryzyko, zapewniając robotom wyraźne ścieżki od strony głównej i stron kategorii do bardziej szczegółowych treści.
Co się dzieje, gdy robot odwiedza stronę?
Po odkryciu adresu URL robot wysyła żądanie do serwera witryny. Odpowiedź może zawierać HTML, obrazy, skrypty, filmy oraz inne zasoby potrzebne do zrozumienia lub wyrenderowania strony. Błędy serwera, wymóg logowania, nieprawidłowe przekierowania lub niedostępne zasoby mogą uniemożliwić robotowi pobranie wszystkiego, czego potrzebuje.
Właściciele witryn mogą wpływać na dostęp robotów za pomocą takich mechanizmów jak robots.txt. Zablokowanie skanowania adresu URL nie jest jednak tym samym co wyraźne wykluczenie go z indeksowania. Jeśli celem jest niedopuszczenie dostępnej strony do indeksów wyszukiwarek obsługujących odpowiednią instrukcję, właściwym rozwiązaniem jest zazwyczaj poprawnie wdrożona dyrektywa noindex. Robot musi mieć dostęp do strony, aby wykryć tę dyrektywę.
Etap 2: jak wyszukiwarki indeksują strony
Po zeskanowaniu strony wyszukiwarka może przeanalizować jej tekst, obrazy, filmy, nagłówki, linki, metadane i inne sygnały. Indeksowanie przez wyszukiwarki to etap, na którym informacje spełniające odpowiednie warunki są przetwarzane i zapisywane w indeksie wyszukiwarki. Zindeksowana strona może potencjalnie pojawić się w wynikach, ale dodanie do indeksu nie następuje automatycznie ani nie jest gwarantowane.
Rozpoznawanie treści i celu strony
Podczas indeksowania systemy próbują określić temat strony, jej język, format oraz powiązania z innymi zasobami. Jasne nagłówki, opisowe tytuły stron, użyteczna treść główna, zrozumiałe linki i dostępne materiały multimedialne uzupełniające treść mogą ułatwić tę interpretację. Wyszukiwarki mogą również przetwarzać dane uporządkowane i sygnały wskazujące ważne elementy strony.
Nie oznacza to, że strona powinna nadmiernie powtarzać jedną frazę. Systemy wyszukiwania potrafią oceniać pojęcia i relacje między słowami, zamiast opierać się wyłącznie na słowach kluczowych w dokładnym brzmieniu. W praktyce celem jest przedstawienie tematu na tyle jasno, aby zarówno odwiedzający, jak i wyszukiwarki rozumieli, na jaką potrzebę odpowiada strona.
Duplikaty stron i wybór wersji kanonicznej
Witryny czasami udostępniają zasadniczo podobne treści pod kilkoma adresami URL. Może się tak dziać z powodu parametrów śledzenia, filtrów, wariantów produktów lub alternatywnych ścieżek URL. Wyszukiwarki mogą grupować identyczne lub niemal identyczne zasoby i wybierać jeden adres URL jako wersję kanoniczną. W rezultacie zeskanowany adres URL może nie zostać osobno zindeksowany, mimo że jego zawartość została przetworzona.
Oznaczenia adresu kanonicznego mogą wskazywać preferowaną wersję, ale są sygnałami, a nie sposobem na wymuszenie dodania każdego adresu URL do indeksu. Spójne linki wewnętrzne, wpisy w mapie witryny, przekierowania i oznaczenia adresu kanonicznego pomagają potwierdzić, który adres URL powinien reprezentować daną treść.
Etap 3: jak wyszukiwarki ustalają kolejność wyników
Ustalanie pozycji następuje, gdy użytkownik wpisuje zapytanie. Wyszukiwarka przeszukuje swój indeks w poszukiwaniu pasujących zasobów i za pomocą automatycznych systemów decyduje, które wyniki prawdopodobnie będą najbardziej trafne i użyteczne. To podstawowa odpowiedź na pytanie o to, jak Google ustala pozycje stron: korzysta z wielu systemów i sygnałów, a nie z jednej uniwersalnej oceny czy listy kontrolnej.
Trafność, znaczenie i użyteczność
Systemy ustalające pozycje próbują zrozumieć znaczenie zapytania, określić, które zindeksowane strony na nie odpowiadają, i wskazać wyniki mogące dostarczyć satysfakcjonującej odpowiedzi. Sformułowanie zapytania ma znaczenie, ale liczą się też powiązane pojęcia, jakość treści, cel strony i kontekst. W zależności od wyszukiwania na dobór prezentowanych wyników mogą wpływać takie czynniki jak język, lokalizacja, urządzenie i aktualność.
Linki mogą wspierać tę ocenę, pomagając systemom zrozumieć relacje między stronami i rozpoznać potencjalnie użyteczne zasoby. Stanowią jednak tylko część znacznie szerszego procesu. Strona nie uzyskuje pozycji wyłącznie dlatego, że ma najwięcej linków przychodzących, używa słowa kluczowego określoną liczbę razy lub należy do witryny z nazwą domeny odpowiadającą zapytaniu.
Dlaczego pozycje różnią się w zależności od zapytania
Ta sama strona może zajmować wysoką pozycję dla jednego zapytania i niską dla innego, ponieważ pozycja zależy od zapytania. Szczegółowy poradnik może odpowiadać wyszukiwaniu informacyjnemu, natomiast strona produktu lub usługi może lepiej spełniać potrzebę związaną z wyszukiwaniem transakcyjnym. W zależności od zapytania mogą też zmieniać się elementy wyników wyszukiwania, dlatego użytkownicy mogą zobaczyć standardowe wyniki, obrazy, filmy, wyniki lokalne lub inne formaty.
Czym różni się skanowanie od indeksowania?
Skanowanie odpowiada na pytanie: „Czy wyszukiwarka może znaleźć ten adres URL i uzyskać do niego dostęp?”. Indeksowanie odpowiada na pytanie: „Czy wyszukiwarka może przetworzyć ten zasób i zapisać go jako wynik, który może zostać wyświetlony?”. Pomyślne skanowanie nie jest więc dowodem na zindeksowanie strony.
Na przykład robot może odwiedzić stronę i wykryć dyrektywę noindex, rozpoznać ją jako duplikat innego adresu URL lub uznać, że nie ma wystarczających powodów, aby zapisać ją osobno. Z drugiej strony informacje o adresie URL mogą czasami pojawić się w indeksie, nawet jeśli robot nie był w stanie uzyskać dostępu do jego pełnej zawartości, zwłaszcza gdy adres ten jest znany dzięki odwołaniom zewnętrznym.
To rozróżnienie ma znaczenie podczas diagnozowania widoczności. Jeśli adres URL nie został odkryty, popraw linkowanie i sygnały ułatwiające jego odkrycie. Jeśli nie można go zeskanować, sprawdź dostęp i odpowiedzi serwera. Jeśli został zeskanowany, ale nie zindeksowany, przeanalizuj dyrektywy, duplikację, wybór wersji kanonicznej i wartość treści. Jeśli jest zindeksowany, ale niewidoczny dla ważnego zapytania, oceń trafność, intencję, jakość i konkurencję.
Dlaczego strona może nie pojawiać się w wynikach wyszukiwania
Brak strony w wynikach nie zawsze oznacza problem z pozycją. Strona mogła napotkać przeszkodę na etapie odkrywania, skanowania lub indeksowania, zanim w ogóle doszło do ustalania pozycji. Może też być zindeksowana, ale uznawana za zbyt mało trafną dla sprawdzanego zapytania. Dokumentacja Google dotycząca sprawdzania adresów URL podkreśla, że zindeksowany adres może pojawić się w wynikach, ale nie ma gwarancji jego wyświetlenia przy każdym wyszukiwaniu.
Typowe przyczyny to brak linków do adresu URL, ograniczenia dostępu robotów, dyrektywa noindex, błędy serwera, problemy z przekierowaniami, zduplikowane treści, nieoczekiwany wybór wersji kanonicznej, niedostępne zasoby lub treść, która nie zapewnia wystarczającej wartości. Odkrycie i przetworzenie niedawno opublikowanej lub zaktualizowanej strony również może wymagać czasu. Mapy witryn i prośby o zindeksowanie mogą wspierać odkrywanie, ale żadne z nich nie gwarantuje dodania do indeksu.
Badając przyczyny braku strony w wynikach, sprawdzaj kolejne etapy po kolei, zamiast od razu zmieniać tytuły lub dodawać słowa kluczowe. Poniżej znajdziesz praktyczną kolejność działań diagnostycznych.
- Upewnij się, że adres URL działa: otwórz go bez logowania i sprawdź, czy wczytuje właściwą treść.
- Sprawdź dostęp robotów: przeanalizuj robots.txt, odpowiedzi serwera, przekierowania i ewentualne wymagania dotyczące uwierzytelniania.
- Sprawdź instrukcje indeksowania: poszukaj dyrektyw noindex i zweryfikuj, czy adres kanoniczny jest odpowiedni.
- Sprawdź sygnały ułatwiające odkrywanie: upewnij się, że do adresu URL prowadzi link z dostępnej strony oraz że właściwy adres znajduje się w mapie witryny, jeśli powinien być w niej uwzględniony.
- Oceń wartość strony: upewnij się, że oferuje odrębną, użyteczną treść, zamiast powielać inną stronę.
- Oceń dopasowanie do zapytania: porównaj cel i format strony z prawdopodobną intencją stojącą za docelowym wyszukiwaniem.
Jak linki i struktura witryny pomagają w odkrywaniu stron
Linki wewnętrzne łączą strony w obrębie tej samej witryny. Umożliwiają odwiedzającym przechodzenie między powiązanymi zasobami i wyznaczają ścieżki, którymi mogą podążać roboty. Opisowy tekst linku dostarcza też kontekstu dotyczącego strony docelowej, zanim otworzy ją człowiek lub wyszukiwarka.
Logiczna struktura zwykle prowadzi od stron ogólnych do bardziej szczegółowych. Na przykład sklep może łączyć stronę główną z głównymi kategoriami, kategorie z podkategoriami, a podkategorie z odpowiednimi stronami produktów. Poradniki uzupełniające ofertę mogą z kolei odsyłać do właściwych kategorii lub powiązanych treści edukacyjnych. Taka hierarchia pomaga wskazać, które strony są ważne i jak poszczególne tematy lub oferty wiążą się ze sobą.
Dostęp do ważnych stron nie powinien zależeć wyłącznie od wewnętrznej wyszukiwarki ani od linków generowanych dopiero po skomplikowanych interakcjach. Wszędzie tam, gdzie jest to wykonalne, powinny prowadzić do nich standardowe linki, za którymi mogą podążać roboty. Mapy witryn mogą stanowić dodatkowy sygnał ułatwiający odkrywanie, ale powinny wspierać wygodną nawigację i linkowanie wewnętrzne, a nie je zastępować.
Jak intencja wyszukiwania wpływa na pozycje
Intencja wyszukiwania to cel stojący za zapytaniem. Użytkownik może chcieć dowiedzieć się, jak coś działa, dotrzeć do konkretnej witryny, porównać dostępne opcje, znaleźć firmę w pobliżu lub dokonać zakupu. Strona ma większe szanse skutecznie konkurować, gdy jej cel i format odpowiadają tej potrzebie.
Specjaliści SEO często opisują intencję za pomocą praktycznych określeń, takich jak informacyjna, nawigacyjna, komercyjna i transakcyjna. Te kategorie są przydatne przy planowaniu, ale rzeczywiste wyszukiwania mogą łączyć więcej niż jedną potrzebę. Osoba szukająca kategorii produktów może chcieć porównać dostępne możliwości i dokonać zakupu podczas tej samej wizyty.
Intencja wyjaśnia również, dlaczego dodanie większej liczby słów kluczowych może nie poprawić pozycji strony. Jeśli wyniki wyszukiwania zawierają głównie instruktaże, krótka strona sprzedażowa może nie dostarczać odpowiedzi oczekiwanej przez użytkowników. Jeśli w wynikach dominują strony produktów lub kategorii, ogólny artykuł może być zbyt odległy od działania, które użytkownik chce wykonać. Uporządkowany proces oceny tych różnic opisano w poradniku dotyczącym badania słów kluczowych i intencji wyszukiwania.
Systemy ustalające pozycje mają rozpoznawać trafne i pomocne wyniki, dlatego treść powinna odpowiadać na rzeczywiste pytanie odwiedzającego, zamiast jedynie naśladować frazy znalezione na stronach konkurencji. Jasno określony zakres, przydatne szczegóły, rzetelne informacje i satysfakcjonujący odbiór treści głównej stanowią solidniejszą podstawę niż powtarzanie słów kluczowych.
Jak sprawdzić, czy wyszukiwarki mogą znaleźć Twoje strony
Właściciele witryn powinni łączyć bezpośrednie sprawdzanie stron z informacjami z oficjalnych narzędzi dla webmasterów. W przypadku widoczności w Google narzędzie do sprawdzania adresów URL w Search Console może pokazać, co Google wie o konkretnym adresie, czy został on zeskanowany, czy jest zindeksowany i którą wersję kanoniczną wybrano. Test wersji opublikowanej może również pomóc wykryć bieżące problemy z dostępem lub możliwością indeksowania.
Rzetelna analiza powinna obejmować każdy etap osobno. Poniższy proces pomaga skupić się na właściwych kwestiach.
- Sprawdź dokładny adres URL: wpisz pełny adres w narzędziu wyszukiwarki dla webmasterów, zamiast sprawdzać wyłącznie domenę.
- Porównaj informacje o wersji zindeksowanej i opublikowanej: zapisana wersja może różnić się od strony dostępnej obecnie w witrynie.
- Przeanalizuj szczegóły odkrycia: sprawdź, czy adres URL znaleziono dzięki mapie witryny, czy innej stronie.
- Przeanalizuj szczegóły skanowania: poszukaj blokad dostępu, nieprawidłowych odpowiedzi serwera, błędów przekierowań lub problemów z wczytywaniem zasobów.
- Przeanalizuj szczegóły indeksowania: potwierdź stan indeksowania i porównaj zadeklarowany adres kanoniczny z wersją wybraną przez wyszukiwarkę.
- Sprawdź skuteczność w wyszukiwarce: jeśli adres URL jest zindeksowany, sprawdź, czy uzyskuje wyświetlenia dla odpowiednich zapytań, zanim uznasz go za całkowicie niewidoczny.
- Poproś o zindeksowanie, gdy jest to uzasadnione: po opublikowaniu lub poprawieniu strony pod ważnym adresem URL prośba o zindeksowanie może skłonić wyszukiwarkę do ponownego sprawdzenia, choć dodanie do indeksu nie jest gwarantowane.
Aby szerzej ocenić dostęp, dyrektywy, wygodę korzystania na urządzeniach mobilnych, wydajność, bezpieczeństwo, mapy witryn i kanonikalizację, skorzystaj z listy kontrolnej technicznego SEO uporządkowanej według priorytetów. Zanim poświęcisz czas na drobne ostrzeżenia techniczne, usuń problemy uniemożliwiające dostęp do ważnych stron lub ich indeksowanie.
Najczęściej zadawane pytania o wyszukiwarki
Czy strona może zostać zeskanowana, ale nie zindeksowana?
Tak. Skanowanie oznacza, że wyszukiwarka uzyskała dostęp do adresu URL, natomiast indeksowanie oznacza, że przetworzyła i zapisała stronę jako wynik, który może zostać wyświetlony. Zeskanowana strona może pozostać niezindeksowana z powodu dyrektywy noindex, duplikacji, wyboru wersji kanonicznej, zastrzeżeń dotyczących jakości lub innego problemu z kwalifikowaniem się do indeksu.
Czy zindeksowana strona może nie pojawiać się w wynikach wyszukiwania?
Tak. Zindeksowanie umożliwia stronie pojawienie się w wynikach, ale nie gwarantuje widoczności dla konkretnego zapytania. Strona może nie być wystarczająco trafna lub konkurencyjna, a na jej wyświetlenie w wynikach mogą wpływać również inne warunki.
Czy przesłanie mapy witryny gwarantuje zindeksowanie?
Nie. Mapa witryny pomaga wyszukiwarce odkrywać nowe lub zaktualizowane adresy URL, ale nie jest poleceniem zeskanowania ani zindeksowania każdej wymienionej strony. Adresy URL w mapie witryny powinny być dostępne, kanoniczne i odpowiednie do wyświetlania w wynikach wyszukiwania.
Czy wyszukiwarki mogą znaleźć stronę bez mapy witryny?
Tak. Roboty mogą odkrywać strony, podążając za linkami ze znanych zasobów. Mapa witryny jest szczególnie pomocna w przypadku witryn dużych, nowych, często aktualizowanych lub złożonych, ale linki wewnętrzne dostępne dla robotów nadal pozostają niezbędne.
Czy robots.txt usuwa stronę z indeksu?
Niekoniecznie. Robots.txt służy przede wszystkim do kontrolowania skanowania. Zablokowany adres URL może nadal być znany dzięki linkom lub innym sygnałom. Aby zapobiec indeksowaniu dostępnej strony przez wyszukiwarki obsługujące tę instrukcję, zastosuj odpowiednią dyrektywę noindex i zapewnij robotowi dostęp do strony, aby mógł ją odczytać.
Ile trwa skanowanie i indeksowanie?
Nie ma ustalonego terminu. Czas przetwarzania może zależeć od witryny, strony, dostępności serwera, linków wewnętrznych, sposobu i częstotliwości aktualizacji oraz innych czynników. Prośba o zindeksowanie lub mapa witryny może przekazać informację, że adres URL istnieje albo uległ zmianie, ale żadne z tych rozwiązań nie zapewnia natychmiastowego efektu ani nie gwarantuje dodania do indeksu.
Czy właściciel witryny może zapłacić za wyższe pozycje w organicznych wynikach wyszukiwania?
Płatne reklamy i organiczne wyniki wyszukiwania są odrębne. Google podaje, że nie przyjmuje opłat za częstsze skanowanie witryny ani za wyższą pozycję strony w organicznych wynikach wyszukiwania.
Najważniejsze wnioski
Najważniejsze informacje o tym, jak działają wyszukiwarki, można podsumować następująco.
- Skanowanie, indeksowanie i ustalanie pozycji to odrębne procesy, które wymagają osobnych działań diagnostycznych.
- Odkryta lub zeskanowana strona nie jest automatycznie dodawana do indeksu wyszukiwarki.
- Zindeksowana strona może pojawić się w wynikach, ale nie ma gwarancji wysokiej pozycji ani widoczności dla każdego zapytania.
- Linki wewnętrzne i logiczna struktura witryny pomagają robotom odkrywać strony i rozumieć ich wzajemne powiązania.
- Systemy ustalające pozycje oceniają trafność, użyteczność, znaczenie i kontekst na podstawie wielu sygnałów, a nie jednego prostego wzoru.
- Intencja wyszukiwania wpływa na to, jaki typ strony i format treści najlepiej odpowiadają danemu zapytaniu.
- Oficjalne narzędzia dla webmasterów dostarczają bardziej przydatnych informacji diagnostycznych niż założenia oparte wyłącznie na ręcznym wyszukiwaniu.
Podsumowanie
Zrozumienie skanowania, indeksowania i ustalania pozycji ułatwia diagnozowanie problemów SEO. Najpierw ustal, czy wyszukiwarka zna adres URL i może uzyskać do niego dostęp. Następnie sprawdź, czy strona spełnia warunki indeksowania i czy wybrano zamierzoną wersję kanoniczną. Dopiero po potwierdzeniu tych etapów skup się przede wszystkim na pozycjach, intencji wyszukiwania, użyteczności treści i trafności strony na tle konkurencji.
W przypadku sklepu internetowego wiedza ta pomaga odróżnić techniczny problem z widocznością od problemu z treścią lub doborem docelowych zapytań. Artykuł Czy muszę znać SEO, aby mój sklep internetowy przyciągał klientów z Google? dostarcza dodatkowego kontekstu właścicielom sklepów, którzy decydują, jak dokładnie powinni poznać SEO i w jakim zakresie samodzielnie się nim zajmować.